Obsidian et Claude Code : structurer un knowledge hub freelance qui capitalise sur chaque mission
Ma connaissance freelance vivait dans 6 endroits différents. Chaque nouveau projet repartait de zéro. Un vault Obsidian que Claude Code lit et alimente directement a résolu le problème : le projet n+1 hérite de tout ce que le projet n a appris.
Lucas Clement
30 mars 2026
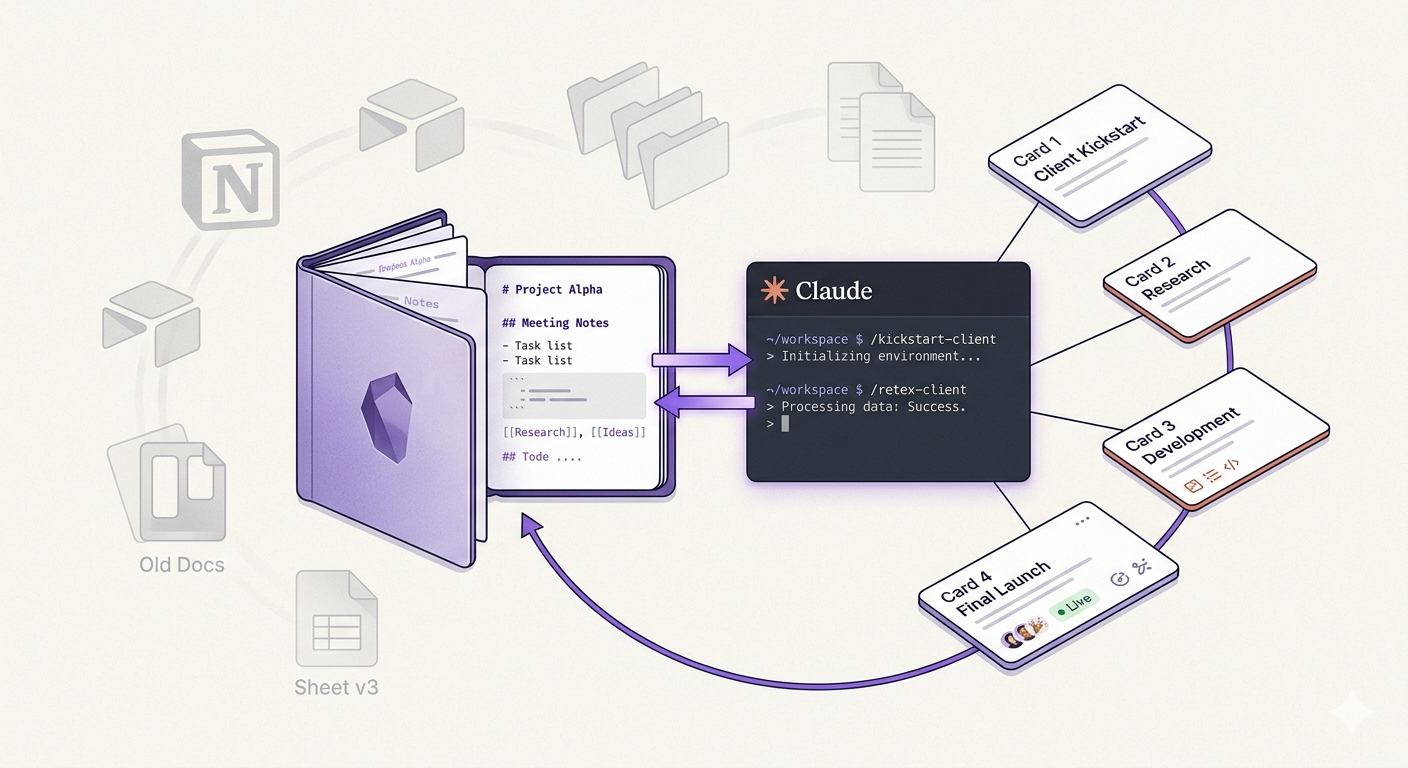
TL;DR : Ma connaissance freelance vivait dans 6 endroits différents. Chaque nouveau projet repartait de zéro. Un vault Obsidian que Claude Code lit et alimente directement a tout changé : le projet n+1 hérite de ce que le projet n a appris. Pour reproduire le système, j'ai écrit un guide pas à pas complet.
Le problème : la connaissance qui se dilue
Après une vingtaine de projets clients, j'ai réalisé que ma connaissance freelance vivait dans une demi-douzaine d'endroits : un dossier Missions avec des fichiers en vrac par client, des repos techniques séparés, un workspace dédié au contenu LinkedIn, des études de cas en double (version courte et longue dans un dossier séparé, parce que pourquoi faire simple), et des dossiers admin qui dupliquaient partiellement les dossiers missions.
Un même client pouvait avoir des traces dans quatre endroits différents. Goodloop existait dans Missions/Goodloop/, Codebases/goodloop-n8n-workflows/, un dossier d'études de cas, et un workspace Claude Code dédié. Quatre endroits, zéro lien entre eux.
Le problème était amplifié par Claude Code. Chaque nouveau projet démarrait de zéro. Claude ne savait rien de mon positionnement, de mon offre, des patterns techniques résolus sur les projets précédents, ni de l'historique avec tel client. Du contexte refourni à chaque session, des apprentissages perdus, des solutions redécouvertes au lieu d'être réutilisées. Chaque mission repartait d'une feuille blanche alors que j'avais déjà rempli le cahier vingt fois.
J'ai essayé les outils classiques d'organisation : Notion, Coda, des bases Airtable. Le problème n'est pas l'outil, c'est la maintenance. Aucun de ces systèmes ne m'a jamais incité à garder la connaissance à jour. On crée les fiches avec enthousiasme, puis on oublie de les alimenter parce que ça demande un effort séparé du travail quotidien. Ce qu'il fallait, c'était un système qu'un assistant IA pouvait maintenir avec moi.
Ce qui a déclenché le passage à l'acte : l'objectif de passer à 8 nouveaux clients par an. Avec plus de clients, la fragmentation allait empirer mécaniquement. Il fallait un système qui capitalise au lieu de diluer.
Le déclic : un dossier de fichiers markdown, rien de plus
Un vault Obsidian, c'est un dossier de fichiers .md sur le disque. Claude Code sait lire et écrire des fichiers .md nativement. Pas d'API, pas de couche intermédiaire, pas de dépendance. Si Obsidian disparaît demain, c'est toujours du markdown lisible par n'importe quoi. C'est peut-être la décision la moins spectaculaire de toute l'architecture, mais c'est celle qui porte tout le reste.
Et surtout, le système est bidirectionnel. Obsidian pour la réflexion humaine, Claude Code pour la capitalisation automatique. Claude ne se contente pas de lire le vault, il l'alimente aussi. Fiches clients, patterns techniques, études de cas : Claude Code crée et met à jour tout ça directement dans les fichiers.
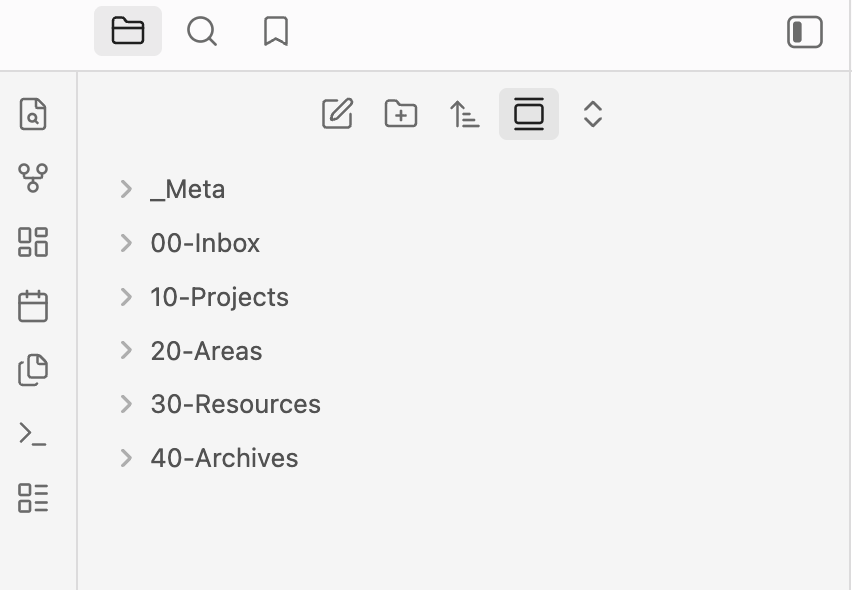
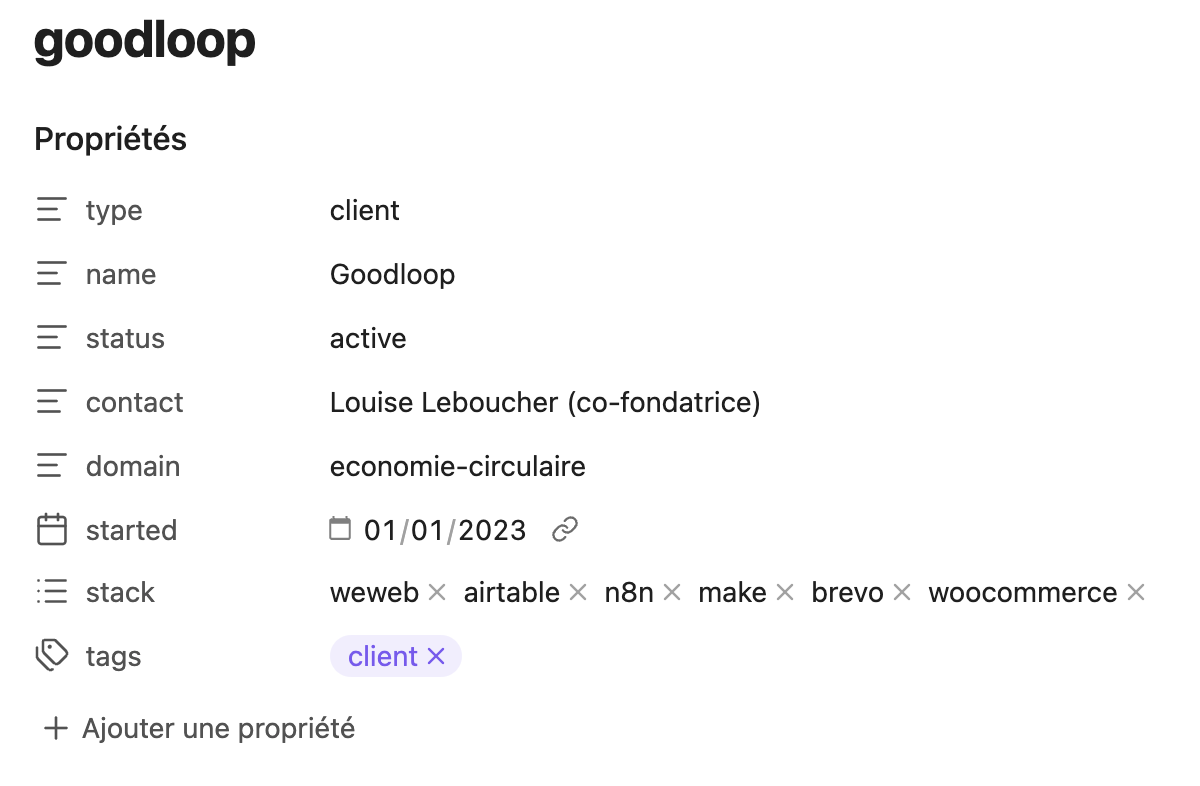
La structure retenue, c'est PARA (Projects, Areas, Resources, Archive) avec des préfixes numériques pour un tri fixe. Trois niveaux de profondeur maximum. Et chaque note a un en-tête structuré qui dit à Claude ce qu'il regarde — fiche client, pattern technique, étude de cas — sans avoir à interpréter le contenu.
Construire le système avec Claude Code
J'ai construit le mien étape par étape, avec Claude Code en copilote. Pas de grand plan en amont. Des notes en vrac, un assistant, et on itère.
Le socle
D'abord, la structure de dossiers. Une seule commande crée toute l'arborescence PARA :
mkdir -p 00-Inbox 10-Projects 20-Areas/{Business,Clients,Content,Tech} \
         30-Resources/{Case-Studies,Frameworks,Templates} 40-Archive _Meta
Ensuite, les fichiers Business qui serviront de fondation : positionnement, offre, stack technique. Ces fichiers seront importés dans chaque projet client. Pour les rédiger, j'ai pointé Claude Code vers mes notes en vrac :
Lis les fichiers de ~/Documents/notes/ et crée une fiche positionnement
structurée dans ~/vault/20-Areas/Business/positionnement.md.
Cible, proposition de valeur, différenciation.
Claude a dégrossi la V1. J'ai ajusté le ton et les nuances. Ça a été pareil pour tout le reste.
Les fiches clients
Pour chaque client, une fiche : contexte, interlocuteurs, ce qui a été livré, apprentissages. J'ai commencé par les 3-4 clients les plus récents, ceux dont le contexte était encore frais.
Lis les fichiers de ~/Documents/Missions/Goodloop/ et crée une fiche client
dans ~/vault/20-Areas/Clients/goodloop-pro.md conforme au schéma
défini dans ~/vault/_Meta/Schema.md.
Claude extrait les informations des notes existantes (emails, briefs, propositions commerciales) et les organise en fiche structurée. En quelques minutes, un client éparpillé dans quatre dossiers a une fiche unique avec tout le contexte.
Le câblage
Là, ça devient concret. Chaque workspace client a un CLAUDE.md avec des @references vers le vault :
@~/vault/20-Areas/Business/positionnement.md
@~/vault/20-Areas/Clients/goodloop-pro.md
@~/vault/10-Projects/goodloop-pro/index.md
@~/vault/_Meta/MOC-Patterns.md
Ces imports chargent automatiquement le contenu dans le contexte de Claude Code. L'essentiel (positionnement, fiche client, index des patterns) est toujours là. Le détail (patterns complets, études de cas), Claude va le chercher quand il en a besoin.
Le test : ouvrir Claude Code dans un dossier projet client et lui demander "Qui est mon client actuel et quel est mon positionnement ?". Il répond avec les infos du vault, sans rien avoir à lui fournir. Si ça répond, c'est câblé.
Les skills
L'architecture ne vaut rien si personne ne la maintient. C'est la leçon de toutes mes tentatives précédentes avec Notion et compagnie : on crée les fiches avec enthousiasme, puis on oublie de les alimenter. Les skills Claude Code automatisent les moments clés.
/kickstart-client prend un nom de client et un brief rapide. En 30 secondes : fiche client, dossier projet, workspace de code avec CLAUDE.md pré-câblé, MOC mis à jour. Le projet est prêt, Claude a le contexte complet dès la première interaction.
/retex-client se déclenche en fin de mission. Claude pose quelques questions, puis met à jour la fiche client, extrait les patterns techniques réutilisables, crée l'étude de cas si pertinent, et archive le projet. Deux minutes, pas plus.
Le retex est ce qui rend le tout cumulatif. Chaque projet terminé enrichit le vault pour les suivants, pas par bonne volonté (ça, j'ai essayé, ça ne tient pas), mais par automatisation.
Ces skills, je les ai co-écrits avec Claude Code. On lui décrit ce que le skill doit faire, il génère le fichier, on teste, on ajuste. Le skill s'améliore à chaque utilisation.
Ce que ça change
Avant : "Nouveau client → créer un dossier → refournir du contexte → reconfigurer Claude Code → oublier ce qu'on a appris."
Après : /kickstart-client "Acme Corp" "PME logistique, portail partenaires" → 30 secondes, Claude a tout le contexte.
Avant : "Fin de projet → fermer le dossier → les apprentissages meurent avec le contexte."
Après : /retex-client → les patterns sont extraits, la fiche client mise à jour, l'étude de cas créée. Le prochain projet hérite de tout ça.
Le cycle se boucle :
Nouveau client
  → /kickstart-client
  → Projet avec contexte complet dès J1
  → Travail normal (le vault est consulté, pas alimenté manuellement)
  → Fin de mission
  → /retex-client
  → Patterns extraits, étude de cas créée, fiche archivée
  → Le vault est plus riche qu'avant
  → Prochain client démarre avec plus de contexte
En chiffres, le vault contient aujourd'hui 12 fiches clients, 3 études de cas structurées, 3 skills d'automatisation, 4 fichiers de positionnement business, et un index de patterns techniques qui grossit à chaque retex. Tout ça s'est rempli sans effort dédié, projet après projet.
Ce qui n'a pas migré (et c'est volontaire) : la facturation et les contrats restent hors du vault. Les repos de code restent en place — leurs CLAUDE.md pointent vers le vault. Les fichiers binaires n'ont pas leur place dans un vault markdown. Le vault stocke la connaissance. Le reste vit ailleurs.
Pour qui, et les limites
Ce système s'adresse aux freelances techniques qui enchaînent les projets clients et utilisent un outil de coding assisté par IA. Le prérequis : être à l'aise avec le markdown et avoir un workflow Claude Code (ou équivalent) déjà en place.
La migration initiale prend quelques jours. Le schéma des notes se stabilise au fil des premiers projets, pas du premier coup. Et le système est optimisé pour Claude Code, même si le principe s'applique à n'importe quel assistant IA capable de lire des fichiers.
Pour un freelance avec 2-3 clients par an et pas d'outil IA, un simple dossier bien organisé fait le travail. Au quotidien, Claude capitalise automatiquement (extraction de patterns, création de fiches, mise à jour des index). L'humain affine les nuances métier. Un retex fait en 2 minutes vaut mieux qu'un retex parfait jamais fait.
Le guide complet pas à pas
Pour reproduire le système de A à Z, j'ai écrit un guide détaillé. De la création du vault à l'automatisation des skills, avec les commandes, les exemples de fichiers, et les prompts Claude Code à chaque étape.
Lire le guide pas à pas complet
Cet article fait partie de la série "Stack moderne pour builder indépendant". Mes projets en détail : Goodloop Pro, Izuba Mobile, BulQ.
Un projet digital à lancer ? Discutons de votre projet.
Un projet en tête ?
Échangeons 30 minutes pour voir comment structurer votre projet digital.
Discutons de votre projet